批作文,人類 VS AI
作文是否必須人類判閱?數據說下。
拉取全部作文手寫圖,OCR 放 Colab 內,A100 正常識別一篇手寫作文是 16 秒/篇,2-3 小時完成,換模型做了一輪校對。看上去差不多可用了就。
畢竟,AI 識別亂的,人類識別一樣會被噁心。
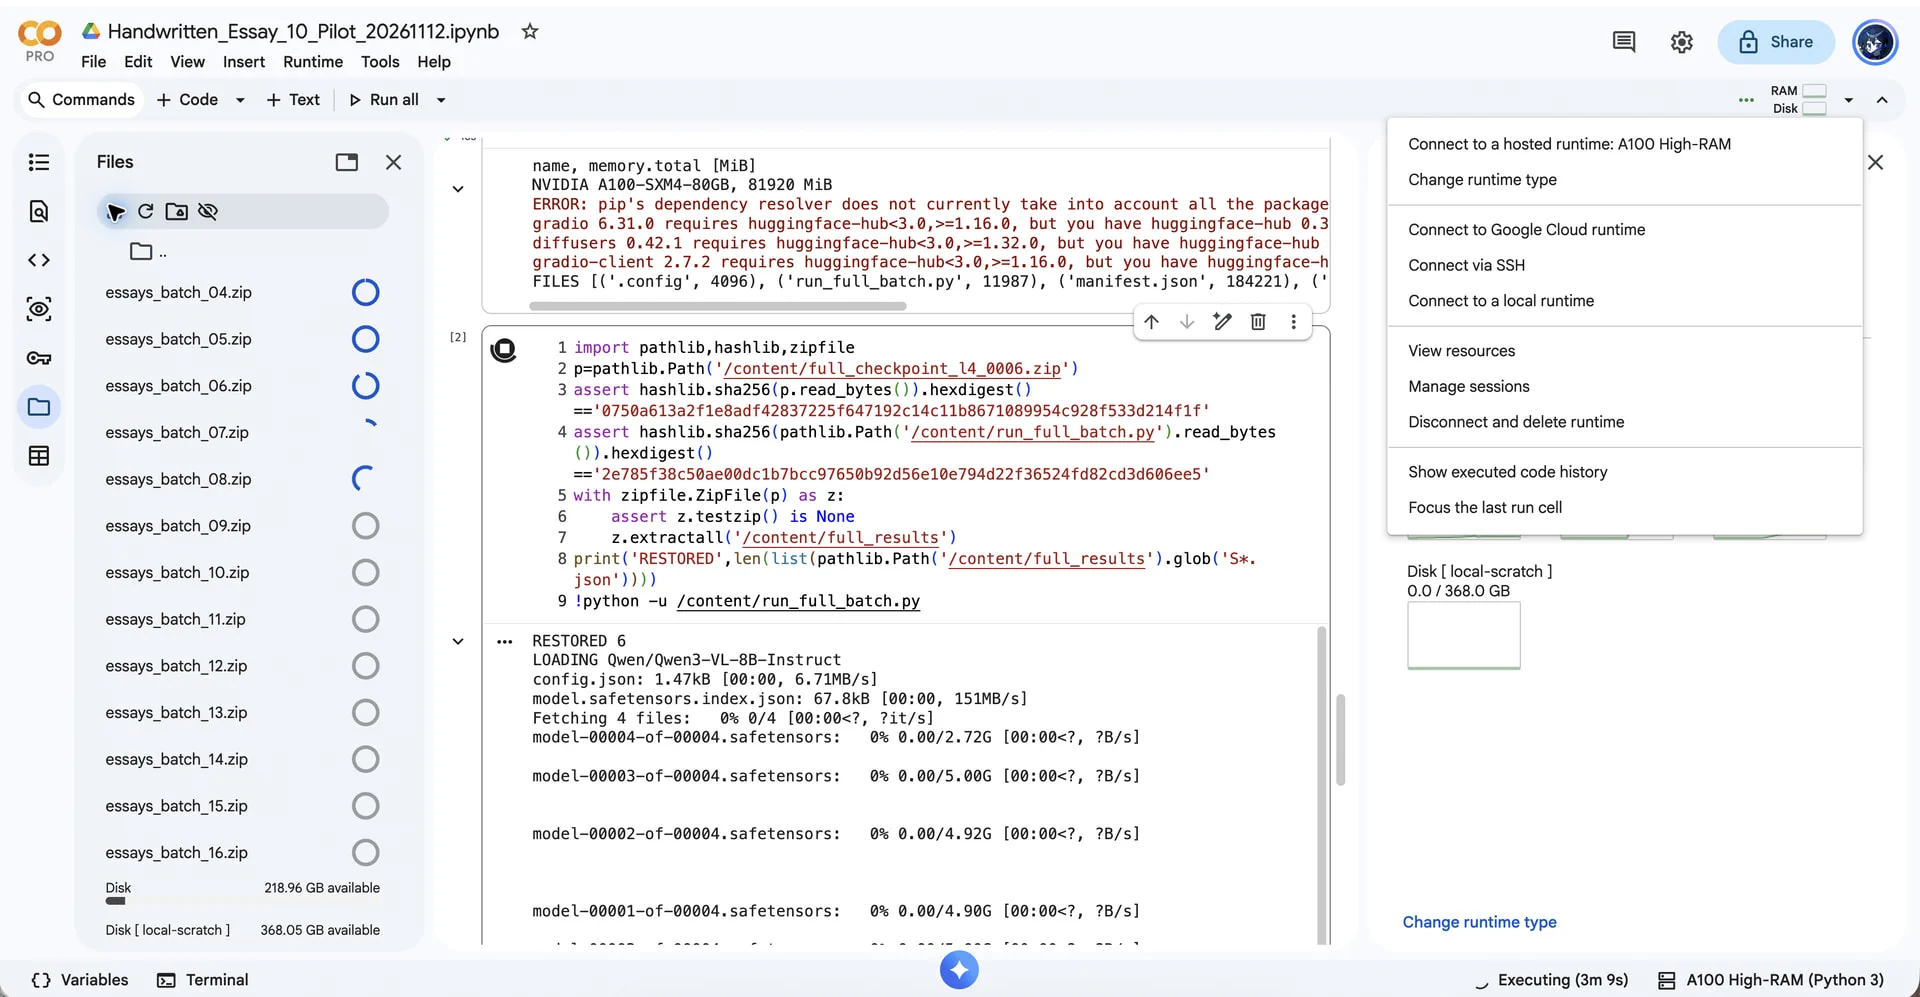
再 2-3 小時 Dots 內全部打分,指令和論壇一致,還是上萬字那個。
然後拉取平台內人類評分,交 AI 做分析報告,如下:
783 份作文:分數接近⋯⋯
基礎信息
兩個題目:議論文《說改過》,記敘文《原來你____在這裡》。同一次考試,同為 40 分,要求不少於 700 字。
資料來自三院 22 個行政班。名冊 816 人,有作文正文並能匹配兩套分數的 783 人;另 33 人沒有作文正文,不參與比較,更不是零分。783 份均有唯一匹配的人類作文分數。
本報告的文體按源題號分:16.1 為議論文,共 586 篇;16.2 為記敘文,共 197 篇。AI 實際採用的文體有 4 篇與源題不同,因此不能把 AI 的 582/201 直接當作試卷的題目分布。
AI 只看識別文字,沒有看原圖,不評書寫。議論文使用既有五十分量尺乘 0.8;記敘文使用 12/12/8/8 的建議量規,並非已核實與人工閱卷完全一致的官方細則。所以,這是一條「識別文字+評閱指令+AI判斷」工作鏈與人工分數的比較,不是純粹的模型智力賽。
本次 AI 評閱由 Suen-Dots 完成;模型名稱按任務方提供標示為 GPT-6 Astra。本報告未以獨立執行記錄核實具體模型版本、參數或 effort,不據此宣稱已比較不同模型。
分數對比
| 指標 | 結果 |
|---|---|
| 人類/AI 平均分 | 30.25/28.41 |
| 人類/AI 中位數 | 30/28 |
| 平均分差(AI-人類) | −1.83 |
| 平均絕對分差 | 2.98 |
| 均方根分差 | 3.69 |
| 絕對分差中位數 | 2.60 |
| 90%篇目的絕對分差不超過 | 6.00 |
| 95%篇目的絕對分差不超過 | 7.00 |
| AI低於/等於/高於人類 | 542/23/218 |
「平均分差」有正負,會互相抵消;「平均絕對分差」先把方向拿掉,再看每篇差多少。後者更接近學生實際面對的問題。
在本批資料裡,69.2% 的 AI 分數低於人類,27.8% 高於人類,只有 2.9% 完全相同。完全同分不是唯一目標,但誤差集中在哪裡、會不會改變判斷,必須說清楚。
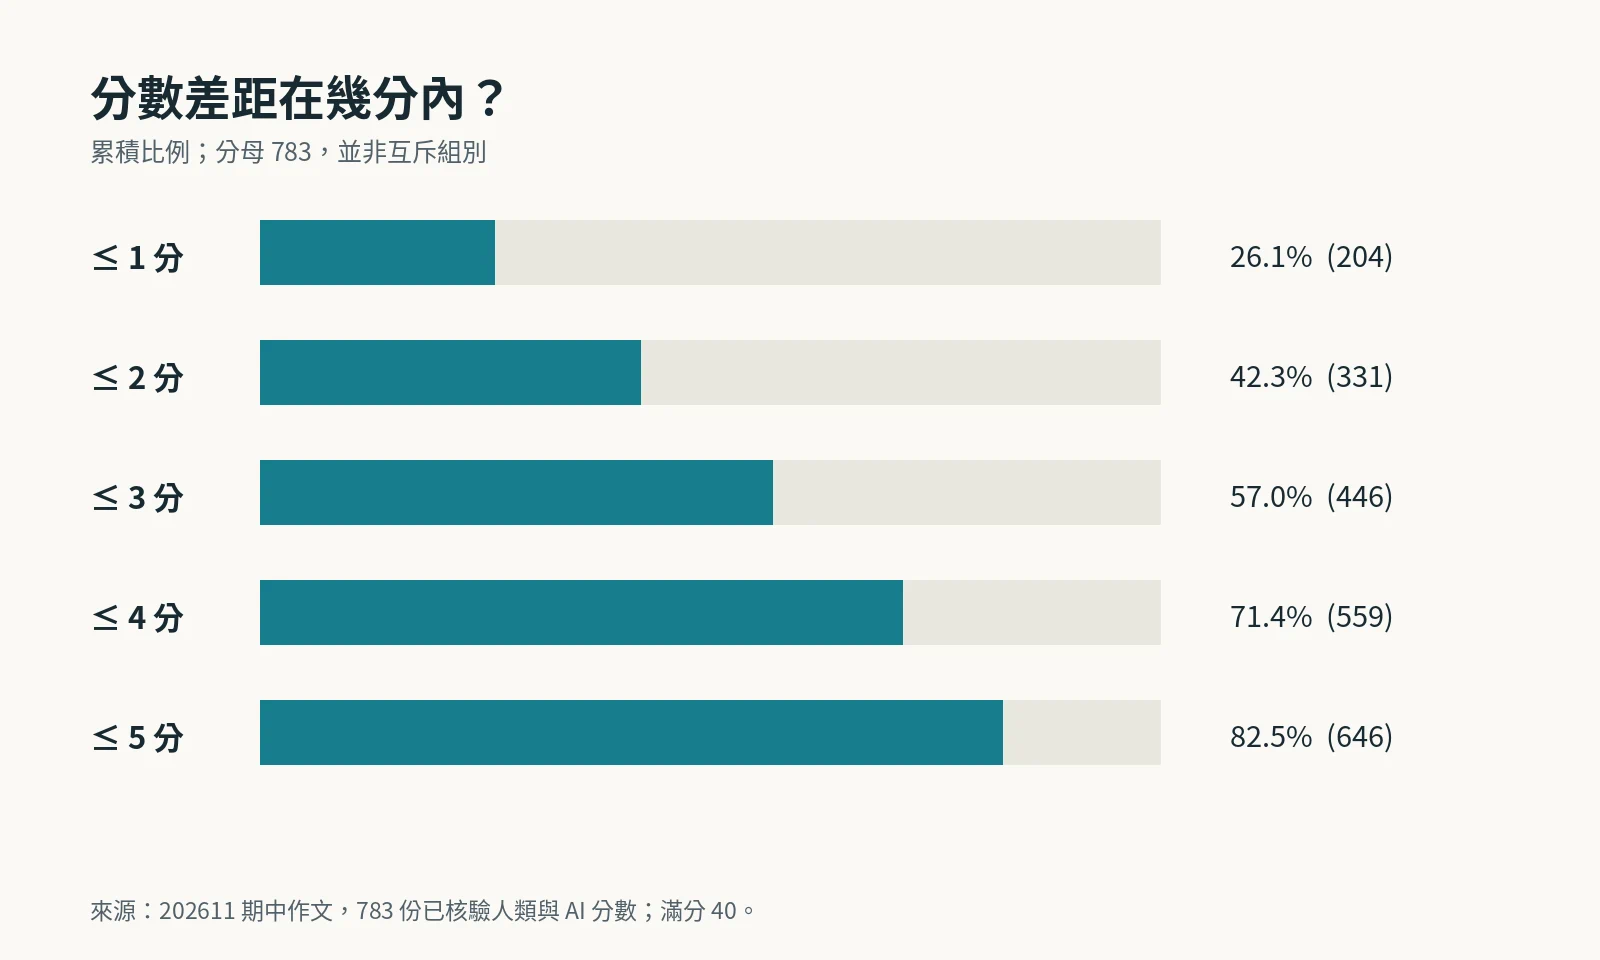
容許分差
| 容許絕對分差 | 符合篇數 | 占783份 |
|---|---|---|
| ≤ 1 分 | 204 | 26.1% |
| ≤ 2 分 | 331 | 42.3% |
| ≤ 3 分 | 446 | 57.0% |
| ≤ 4 分 | 559 | 71.4% |
| ≤ 5 分 | 646 | 82.5% |
若把相近定為兩分內,只有 331 篇,42.3%。放寬到三分內,是 446 篇,57.0%。五分內雖有 646 篇,但五分已是滿分的八分之一,不能只因數字好看就叫它「準確」。這些是描述門檻,不是本次官方容許誤差標準。
另須分清:差「至少五分」是 154 篇,差「超過五分」是 137 篇。恰好五分的 17 篇同時包含在「五分內」和「至少五分」中,兩個口徑不能直接相減。
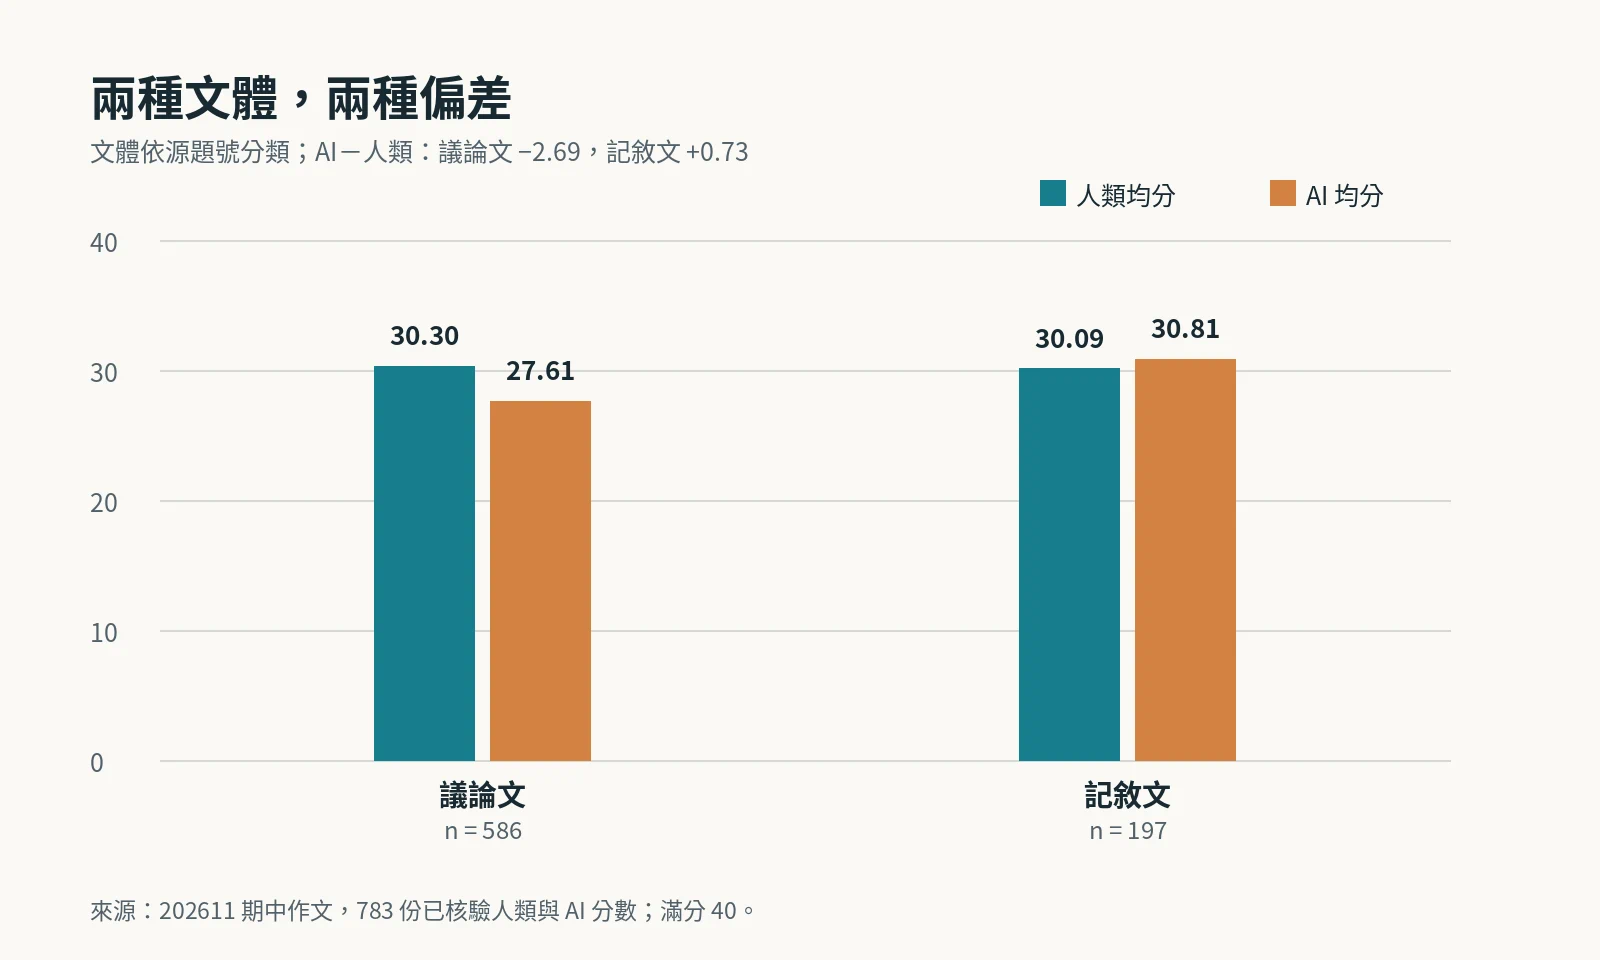
不同文體
| 文體 | 篇數 | 人類均分 | AI均分 | AI-人類 | 絕對分差 |
|---|---|---|---|---|---|
| 議論文 | 586 | 30.30 | 27.61 | -2.69 | 3.16 |
| 記敘文 | 197 | 30.09 | 30.81 | 0.73 | 2.45 |
議論文 586 篇中,472 篇的 AI 分數低於人類,占 80.5%;132 篇相差至少五分,占 22.5%。記敘文 197 篇中,117 篇 AI 分數更高,占 59.4%;相差至少五分的 22 篇,占 11.2%。
三分內一致率,議論文是 52.0%,記敘文是 71.6%。後者明顯較好,但「較好」不能直接換成「可以獨立登分」。它仍有兩成多篇目超出三分。
原因暫不能只歸到某一件事:議論文量規可能更嚴,識別文字可能損傷抽象論證,人工給分的尺度也可能不同。這些都是待核查的解釋,並非已證明的因果。
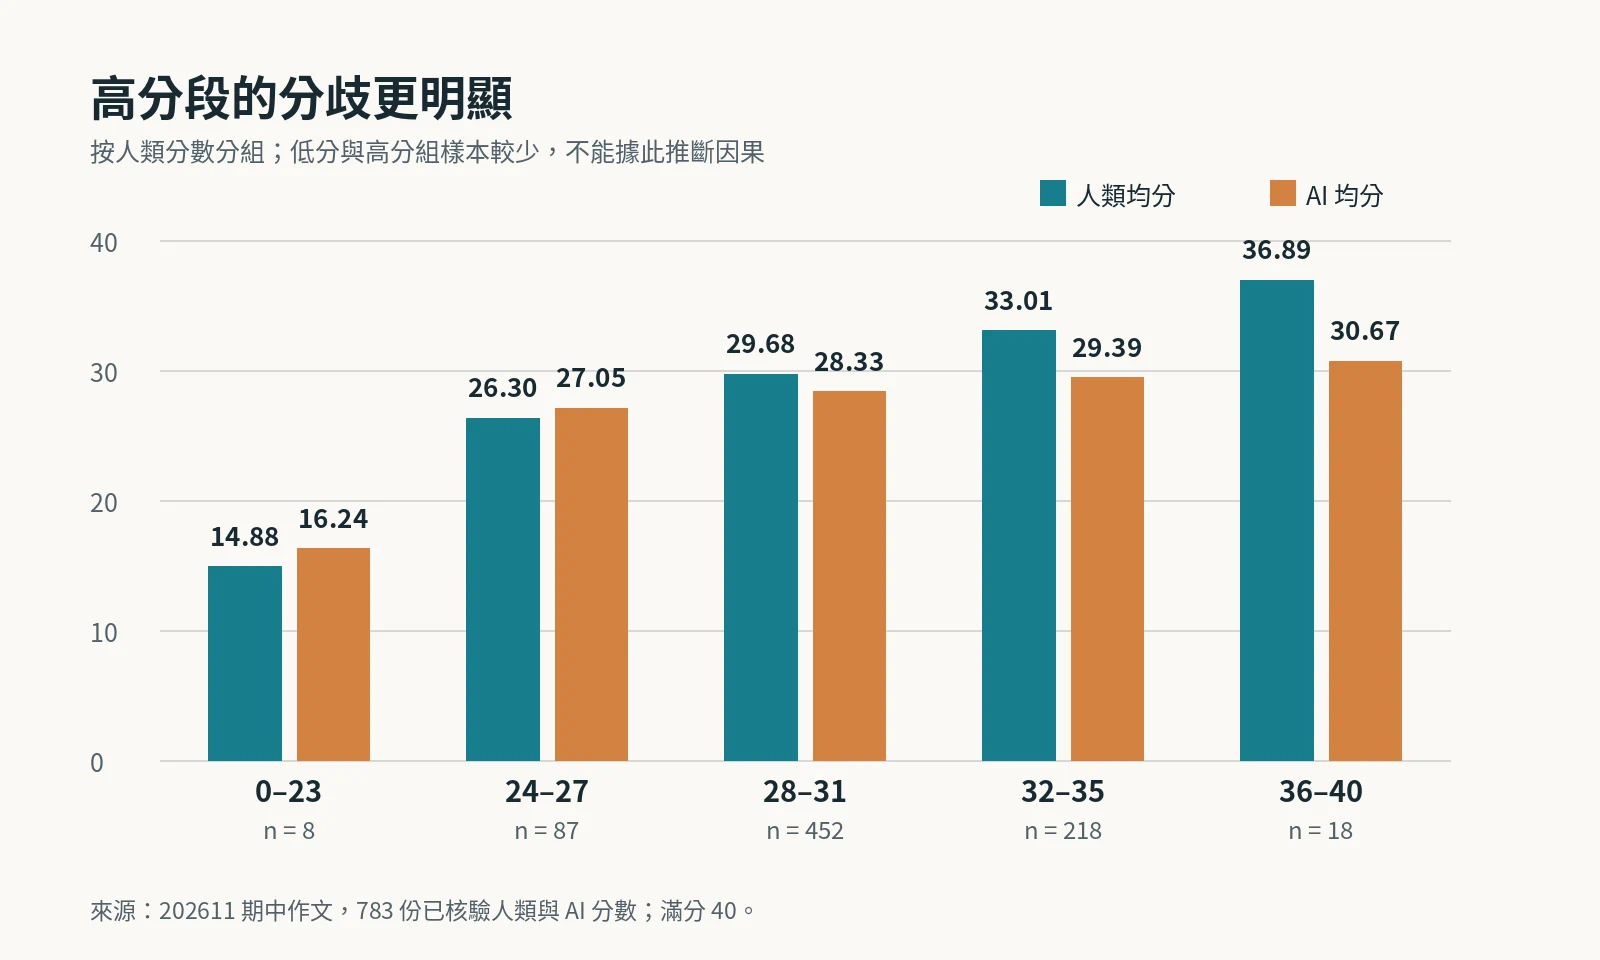
分數分段
| 人類分數段 | 篇數 | AI平均分 | 平均分差 | 絕對分差 |
|---|---|---|---|---|
| 0–23 | 8 | 16.24 | 1.36 | 2.39 |
| 24–27 | 87 | 27.05 | 0.75 | 2.47 |
| 28–31 | 452 | 28.33 | -1.35 | 2.49 |
| 32–35 | 218 | 29.39 | -3.63 | 3.96 |
| 36–40 | 18 | 30.67 | -6.22 | 6.22 |
人類給到 36 分及以上的 18 篇,AI 全部給得更低,平均低 6.22 分。它們沒有任何一篇被 AI 保留在 36 分及以上。反過來,AI 給出的 3 篇 36 分及以上,都不是這 18 篇。
若以 32 分作一條純分析用的切線:人類有 236 篇達到,AI 有 112 篇達到,其中共同達到的只有 49 篇;187 篇只有人類達到,63 篇只有 AI 達到。不是把整體平移一兩分,就能自然恢復原來的判斷。
這裡的切線不是另立等第,更不是建議按它處置學生。按人類分數分組,本來就會帶入選擇與回歸效應;尤其低分組只有 8 篇,高分組只有 18 篇,不能拿來概括所有考試。但本批高分作品的分歧確實存在,應列入優先覆核。
相關分析
全部 783 篇,Pearson 相關為 0.461,Spearman 等級相關為 0.294。前者看兩套分數的線性聯動,後者更關心高低排序。都不是「準確率」。
分文體看,議論文的等級相關為 0.318,記敘文為 0.469。這至少提醒我們:不能一面承認總分有偏差,一面就假定名次大致不變。排名是否可靠,也需要單獨核查。
而「穩定」是另一個尚未回答的問題。目前沒有同一模型對同一文本多輪獨立打分,也沒有多位教師對同一批文本的盲評。一次相關不能證明重複評分穩定,更不能估出人類自身分歧的上限。這個報告回答的是本次兩套分數差在哪裡,不替缺少的實驗補結論。
三院差異
| 範圍 | 篇數 | 人類均分 | AI均分 | 平均分差 | 絕對分差 |
|---|---|---|---|---|---|
| 元培 | 252 | 31.19 | 28.50 | -2.69 | 3.46 |
| 未名 | 98 | 28.52 | 27.12 | -1.40 | 2.90 |
| 行知 | 433 | 30.08 | 28.65 | -1.43 | 2.72 |
元培的絕對分差較大,行知較小。但三院的文體比例、作文表現、人類評分尺度、掃描與識別條件都未被控制。這不是學院教學質量排名,也不是某一組閱卷教師「更準」的證明。
之前 70 份只來自兩個教學班,平均絕對分差 2.15 分,兩分內一致率 61.4%;擴展至全體後,分別變成 2.98 分、42.3%。不是模型在這一刻突然退步了,而是原先那 70 份並非全體的隨機代表。小樣本用來試流程可以,用來替全體宣布效度,就早了。
可能問題
以下不是重新打分,而是把已有評語與分數放回同一張桌上。
| 編號 | 人類 | AI | AI-人類 | 既有評語已提示的問題 |
|---|---|---|---|---|
| S0748 | 36 | 24 | −12 | 主題詞系統誤識,多段嚴重混接;僅評現存可辨文字 |
| S0543 | 34 | 23.2 | −10.8 | 題目和關鍵詞反覆疑誤,內耗段混接 |
| S0344 | 28 | 19 | −9 | 多段混接,結尾不可讀,無法確認故事完成方式 |
| S0660 | 18 | 24 | +6 | 源題為議論文,AI按旅行敘事改用記敘文量規 |
前三篇的重要處,不是已經證明 OCR 導致全部分差,而是 AI 自己的評語已明示:現存文字不足以還原完整原稿。這時候仍給出的數字,只能表示對殘存文本的候選判斷,不能無縫變成學生原作的成績。
「疑似識別錯字不另扣分」還不夠。即使沒有單列錯字扣分,缺失的論據仍會讓材料分下降,混接的句子仍會損傷結構和語言。技術損耗可以繞過錯字項,進到其他維度裡。這正是需要核查的地方。
本報告沒有重新看這些原圖,不能據此裁定誰對誰錯。下一步應用校正後的同一文本盲評,再看分差是否縮小。先把輸入修對,再談評分模型的高下。
文本髒淨
既有評語中,有 202 篇被「缺失、截斷、嚴重、混接、無法推斷」等關鍵詞標出。這份清單可以幫忙定位,卻不是人工確認的 OCR 錯誤清單;沒有被標出的 581 篇,也不能叫作「乾淨文本」。
| 分組 | 篇數 | 平均分差 | 平均絕對分差 | 兩分內 | 至少五分 |
|---|---|---|---|---|---|
| 文字疑點候選 | 202 | −2.65 | 3.46 | 72/202,35.6% | 53/202,26.2% |
| 其餘篇目 | 581 | −1.55 | 2.82 | 259/581,44.6% | 101/581,17.4% |
排除 202 篇候選,平均絕對分差只是從 2.98 降至 2.82 分。其餘 581 篇仍有 101 篇相差至少五分,不能把整體問題全部交給 OCR 背鍋。
分文體再看:議論文候選 147 篇的絕對分差為 3.86,其他 439 篇為 2.93;記敘文候選 55 篇為 2.39,其他 142 篇為 2.47。候選標記並非在兩種文體都對應更大的絕對分差,更不能把它直接當作損傷程度。
這是敏感性分析,不是修復實驗。標記來自同一批 AI 評語,可能帶入評閱者本身的判斷,也可能漏檢或誤命中;兩組的人類分數分布不同。它能說明「排除候選後,結論是否改變」,不能估算「OCR造成了多少分差」。33 份缺正文、4 份文體差異與這 202 份是不同口徑,不能混為一談。
四篇不一
| 編號 | 源題 | AI採用 | 人類 | AI | 分差 |
|---|---|---|---|---|---|
| S0582 | 議論文 | 記敘文 | 27.0 | 28.5 | 1.5 |
| S0588 | 議論文 | 記敘文 | 26.0 | 30.0 | 4.0 |
| S0340 | 議論文 | 記敘文 | 25.0 | 27.5 | 2.5 |
| S0660 | 議論文 | 記敘文 | 18.0 | 24.0 | 6.0 |
源題號與實際文章可以不一致:學生可能選錯格,也可能寫偏題,轉寫本身也可能損壞題頭。現在能確認的是差異,不能只憑哪套分類更順眼就覆蓋另一套。
本報告按源題號統計,保留 AI 採用量規及覆核標記,不改原分。即便暫時排除這四篇,剩餘 779 篇的平均絕對分差仍為 2.98 分,整體結論沒有被四個例外撐起來。
有限診斷
做了一個有限的診斷:只估計每種文體的平均偏差,不改變原分,不回寫成績。把資料按匿名編號的固定雜湊分成五組,每次只用其他四組估計偏移,再對留下的一組計算分差。
這個交叉驗證式偏移診斷,平均絕對分差從 2.98 降到 2.30 分,均方根分差從 3.69 降到 2.84 分;兩分內的篇數從 331 增到 409,即 52.2%;至少五分分差的篇數從 154 減到 55。
說明平均尺度偏差確實占了一部分,但不是全部。連這種只追平均偏差的辦法都還有近一半超過兩分,更不能把「議論文統一加 2.69」拿去當最終方案。
這仍是同一次考試內的探索,跨班相關、量規差異與資料選擇都還存在;沒有證明它對下一次考試有效。真正的校準應先固定量規和評語證據,再用未參與調整的新卷驗證。不能看完答案再把模型調到像答案,最後宣布模型原本就準。
繼續磨刀
一,原分不動,先建立覆核清單。 154 篇大分差、4 篇文體不一致,以及已明示正文損壞的候選篇目優先。這些集合可能重疊,不相加當作總量。大分差是定位線索,不是錯分證據。
二,分開識別和評分兩個問題。 對抽取的高分、中段、低分與兩種文體,準備經確認的純文本。用同一指令分別評現有識別稿與校正稿。只在輸入改變時比較分數,才知道校對到底救回了多少判閱信息。
三,量規對齊,不靠一句「像人類」。 先確認本次人工尺度,尤其議論文論據與論證要求、記敘文題意和敘事完成度。將可接受的等價表現寫清楚,不額外獎勵口號,不以術語數量代替內容,不把 AI 偏好的文章當成唯一好文章。
四,盲評,而不是對著人類分數改評語。 人類分數只用於事後對比;新一輪評閱不把它輸入模型。同一文本重複評閱,多位教師抽樣獨立核查,才能區分模型不穩、人工差異和輸入損耗。正式成績仍由有權教師確認。
五,驗收門檻先寫,結果出來再算。 可以討論兩分內、三分內、關鍵分數段誤判、大分差比例,但門檻應由教學需要決定,不是由哪個數字比較漂亮決定。新一輪必須同時報分文體結果,不只報一個總平均。
我想要的不是一個永遠說「需人工」的系統,也不是一個每篇都能自信吐出分數的系統。要的是能省下人不必做的重複勞動,同時把真正影響判斷的地方留給人。這批數據已經把下一步指得很清楚:不是再湊一次全量完成,而是把分歧查清楚。
數字口徑
分差固定為 AI 減人類;正值表示 AI 較高,負值表示 AI 較低。平均絕對分差為每篇分差絕對值的均值;均方根分差對大差距更敏感。百分比以相應組別的有效篇數為分母,顯示值四捨五入,原分未取整。
人類分數來自本次 22 班官方題分匯出;AI 分數來自已保存的文字評閱候選結果。上游已核對身份、題號、滿分及來源雜湊,本報告重新計算了所有主要統計,沒有修改學生分數。班級與學生逐份對應在受限管理頁查看,本報告不含姓名、學號、原圖或作文全文。
人評在此是比較基準,不是已驗證的無誤真值。缺少人類雙評一致性、同模型重複評閱、經人工確認的全量文字真值,以及與人工完全一致的量規證據。因此不能由目前分差單獨算出 OCR 準確率、模型獨立能力或正式評分可靠度。成本和耗時也沒有完整逐篇記錄,本報告不補造。
資料截點:2026 年 11 月 12 日。本報告僅描述這次考試,不把它外推成所有作文、所有模型或所有教師的結論。
如上,如是。
參照之前這篇內分差等:
個人觀點,作文和其他考題,人類,可以不閱了⋯⋯